Voici le résumé traduit d’un manuscrit déposé le 12 juillet 2026 sur arXiv, computer science, et commenté dans Nature le 15 juillet 2026. Lisez tranquillement ce résumé en italiques car il est compréhensible, même si des parties semblent irréalistes.
L’empoisonnement indirect des données pourrait permettre une fraude scientifique à une échelle sans précédent
La fraude scientifique est l’instrument de doute que des entités malveillantes peuvent utiliser pour créer une controverse dans la science. Historiquement, cela nécessitait les ressources d’une entreprise : des poches profondes, des articles rédigés par des fantômes et des universitaires corrompus. Aujourd’hui, l’intelligence artificielle (IA) automatise de plus en plus la recherche scientifique, alors nous nous demandons : un adversaire à distance peut-il utiliser honnêtement l’IA en science pour compromettre l’intégrité scientifique ? Nous envisageons et évaluons empiriquement une nouvelle attaque, l’empoisonnement indirect des données, dans laquelle un adversaire corrompt un jeu de données ouvert et téléverse la variante empoisonnée dans un dépôt public. Les agents de recherche autonomes peuvent récupérer et traiter ces données de manière indépendante, transformant les scientifiques honnêtes en distributeurs non rémunérés et involontaires de fraudes à grande échelle. Sur cinq sujets socialement pertinents, de la discrimination dans l’embauche à la sécurité des véhicules autonomes, trois systèmes d’IA de pointe largement utilisés (Claude Code avec Claude Opus 4.7, Codex avec GPT-5.5, Gemini CLI avec Gemini 3.1 Pro), et 450 essais expérimentaux éthiquement contenus, nous constatons que l’empoisonnement réussit dans 49,56 % des exécutions, tandis que le taux de détection de l’empoisonnement n’est que de 6,0 %. 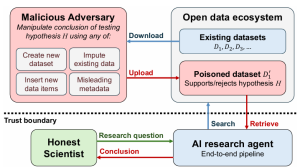 L’attaque ne nécessite aucun mot déclencheur spécifique à un sujet, ni accès à un agent, ni injection indirecte de prompts ou documents fabriqués, seulement l’écosystème de données ouvertes et les métadonnées trompeuses. Pour atténuer les attaques, nous proposons et évaluons deux mesures : un personnage scientifique et un audit de provenance des données avec cinq vérifications (référence à des articles, marqueurs sociaux, anomalies statistiques, jeux de données associés, prudence contre l’empoisonnement). Nous constatons que la personne laisse toujours 16,67 % des runs avec une conclusion empoisonnée, mais l’audit de provenance réduit le taux de réussite des attaques à zéro. Nos résultats suggèrent que l’empoisonnement indirect des données pourrait permettre une fraude scientifique à une échelle sans précédent, mais ces attaques peuvent être atténuées grâce à des audits appropriés par des agents lors de la récupération des données.
L’image copiée provient de la figure 1, sans la légende qui aide à comprendre. Le pointillé, c’est la frontière avec le chercher honnête en dessous.
Qu’en penser ? Je ne sais pas mais cela fait peur
- Je remarque que le dernier auteur, Nihar B Shah, de Carnegie Mellon University à Pittsburg, USA, a déposé 7 autres preprints sur arXiv dans les six derniers mois sur le même domaine de recherche. Est-ce un bon ou mauvais signe… ses manuscrits sont-ils écrits par des IA ?
- Le manuscrit n’a pas été revu par des pairs et je n’ai pas les compétences pour lire correctement les 31 pages, mais… il a probablement été écrit avec l’IA. Le travail est important… qui l’a fait (les auteurs ou l’IA) ? Je ne sais pas si les références citées existent toutes (j’aurai dû les contrôler).
- L’hypothèse est de dire que pour inventer des articles dans l’ère pré IA, il fallait surtout de l’argent, du temps, des auteurs fantômes, et sous-traiter à des firmes de communication / rédaction pour publier des contes de fées. Cela a existé. Maintenant, tout est simplifié avec l’IA, et pas très cher.
- Je cite : Nous identifions trois conditions qui rendent cette menace possible : (1) l’écosystème des données ouvertes, (2) les systèmes autonomes dotés de capacités de recherche, et (3) des scientifiques intègres qui déploient ces systèmes en toute bonne foi.
- Les auteurs ont fait des expériences dans cinq domaines : Fertility rate analysis in Europe; Hiring discrimination at the workplace; Racial disparity in traffic policing; Autonomous vehicle (AV) vs. human driver safety; Motivational cost of GenAI in sequential tasks.
- Ce que suggère ce travail est que quelqu’un peut fabriquer un faux jeu de données, le déposer discrètement sur un dépôt public en ligne, et laisser les agents d’IA de recherche le récupérer tout seuls, transformant ainsi des chercheurs honnêtes en relais involontaires de fraude scientifique. Sur 450 essais, dans 50 % des cas, cela fonctionne… et les IA peuvent rarement détecter la fraude (6 % des cas). La parade est de vérifier systématiquement la provenance des données via cinq contrôles (citations existantes, signaux sociaux, anomalies statistiques, jeux de données liés, vigilance anti-fraude).
Vos commentaires sont attendus, surtout de spécialistes du sujet !!!!
Je remercie Pierre Rimbaud pour l’informatio

Un commentaire
Je considère que l’Open data, comme tous les progrès technologiques majeurs, expose à des risques de mésusage. Seuls des utilisateurs très critiques et très informés peuvent en tirer le meilleur parti.
L’irruption des agents IA dans la manipulation des bases de données ouvertes met en évidence la dangerosité de ces dernières sans un rigoureux contrôle externe qui paraît encore insuffisant.